
FleXray: ناحیه بندی خودکار ۶۰ ساختار آناتومیکی در تصاویر X-ray با هوش مصنوعی
تصاویر رادیوگرافی یا X-ray از پرکاربردترین روشهای تصویربرداری پزشکی هستند. اما استخراج خودکار اطلاعات کمی از این تصاویر، بهویژه برای ساختارهای آناتومیکی مختلف، همچنان چالشبرانگیز است. یکی از دلایل اصلی این مسئله، نمایش ساختارهای سهبعدی بدن بهصورت یک تصویر دوبعدی است که باعث همپوشانی اندامها و دشوار شدن تعیین مرز آنها میشود. در مقالهی FleXray: Universal Clinical X-ray Segmentation، پژوهشگران روشی مبتنی بر یادگیری عمیق (deep learning) معرفی کردهاند که میتواند ۶۰ ساختار آناتومیکی را در تصاویر X-ray بخشبندی کند. ایدهی اصلی این پژوهش، استفاده از دادههای CT سهبعدی برچسبگذاریشده برای تولید تصاویر رادیوگرافی مصنوعی با برچسبهای دقیق است. سپس با ترکیب این دادهها و تصاویر واقعی، مدلی عمومی برای تحلیل آناتومی در تصاویر X-ray آموزش داده میشود. نتایج ارزیابی روی هشت مجموعهدادهی مستقل نشان میدهد که FleXray میتواند در نواحی مختلف بدن و شرایط تصویربرداری متفاوت عملکرد مناسبی داشته باشد. پژوهشگران همچنین کاربرد آن را در اندازهگیری خودکار زاویهی Cobb برای ارزیابی اسکولیوز، بهبود ثبت تصاویر دوبعدی و سهبعدی در مداخلات هدایتشده با X-ray و آموزش مدلهای تخصصی با دادهی کمتر بررسی کردهاند. مقاله نشان میدهد که ترکیب شبیهسازی فیزیکمحور، دادههای مصنوعی و یادگیری عمیق میتواند راهی برای تبدیل تصاویر رادیوگرافی معمول به دادههای ساختاریافته و قابلاندازهگیری فراهم کند.
۱. مقدمه: چرا تحلیل خودکار تصاویر X-ray دشوار است؟
تصور کنید یک تصویر X-ray از قفسهی سینه در اختیار داریم. در این تصویر، ریهها، قلب، دندهها و سایر ساختارها بهصورت یک تصویر دوبعدی دیده میشوند؛ درحالیکه هرکدام در فضای سهبعدی بدن قرار دارند.
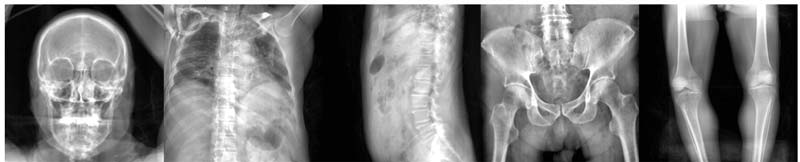
در تصویربرداری CT، برشهای متعددی از بدن در اختیار داریم و میتوانیم ساختارهای مختلف را در حجم سهبعدی بررسی کنیم. اما در X-ray، اطلاعات مسیر عبور پرتوها روی یک صفحهی دوبعدی جمع میشود. بنابراین ممکن است چند ساختار آناتومیکی روی هم بیفتند و مرز دقیق آنها بهسادگی قابل تشخیص نباشد.
این موضوع یک چالش مهم برای الگوریتمهای Image Segmentation ایجاد میکند.
بخشبندی تصویر یا Segmentation یعنی مشخص کردن پیکسلهای متعلق به یک ساختار مشخص؛ برای مثال، تعیین پیکسلهای مربوط به ریهها، مهرههای ستون فقرات یا استخوان ران.
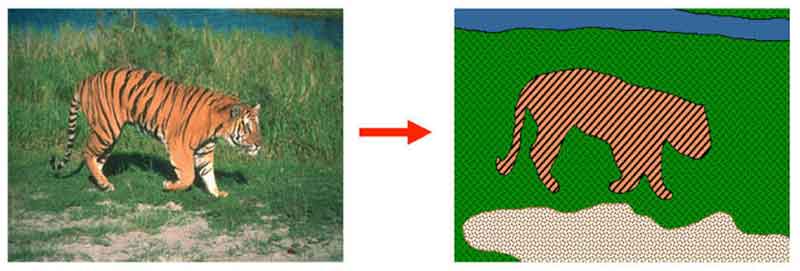
در بسیاری از کاربردهای پزشکی، هدف فقط تشخیص وجود یک ساختار نیست. گاهی لازم است شکل، اندازه، موقعیت یا تغییرات آن در طول زمان اندازهگیری شود. برای انجام این کار، به بخشبندی دقیق و قابلاعتماد نیاز داریم.
چرا نمیتوان تصاویر X-ray را بهراحتی برچسبگذاری کرد؟
آموزش یک مدل نظارتشده برای بخشبندی معمولاً به تصاویر و ماسکهای مرجع نیاز دارد. این ماسکها مشخص میکنند هر پیکسل به کدام ساختار آناتومیکی تعلق دارد.
اما برچسبگذاری پیکسلی تصاویر X-ray، بهویژه زمانی که چندین اندام روی هم قرار گرفتهاند، زمانبر و دشوار است. علاوه بر این، تصاویر رادیوگرافی از نظر زاویهی تصویربرداری، ناحیهی بدن، وضعیت بیمار، دستگاه و تنظیمات تصویربرداری تفاوت زیادی دارند.
در نتیجه، مجموعهدادههای موجود معمولاً پوشش محدودی از ساختارها و شرایط تصویربرداری دارند. بسیاری از مدلها برای یک ناحیهی خاص، مانند ریهها یا استخوانهای دست، طراحی شدهاند و الزاماً نمیتوانند همان عملکرد را در سایر نواحی بدن ارائه دهند.
سؤال اصلی پژوهش FleXray این است: آیا میتوان از برچسبهای دقیق تصاویر CT سهبعدی برای تولید دادهی آموزشی موردنیاز بخشبندی تصاویر X-ray استفاده کرد؟
۲. FleXray چیست؟
FleXray یک مدل عمومی مبتنی بر یادگیری عمیق برای بخشبندی آناتومیکی تصاویر X-ray است که در مقالهای با عنوان FleXray: Universal Clinical X-ray Segmentation معرفی شده است.
این پژوهش توسط Victor Ion Butoi، Vivek Gopalakrishnan، John V. Guttag، Adrian V. Dalca و Neel Dey انجام شده است.
برخلاف مدلهایی که فقط یک ساختار یا یک ناحیهی خاص را بخشبندی میکنند، FleXray برای کار با تصاویر رادیوگرافی از نواحی مختلف بدن طراحی شده است. این مدل میتواند ۶۰ ساختار آناتومیکی، از جمله بخشهایی از اسکلت، مهرههای ستون فقرات، ریهها، قلب، کبد، طحال و کلیهها را بخشبندی کند.
نکتهی مهم این است که منظور از مدل عمومی، مدلی با پوشش گستردهتر در محدودهی تعریفشدهی پژوهش است؛ نه مدلی که بتواند هر نوع تصویر پزشکی یا هر ساختار بدن را بدون محدودیت تحلیل کند.
مقاله و کد پروژه:
- مقالهی علمی: https://arxiv.org/abs/2609.26756
- مخزن کدGitHub: https://github.com/VictorButoi/FleXray
- صفحهی رسمی پروژه و دموی آنلاین: https://flexray.csail.mit.edu/
۳. روش پیشنهادی FleXray؛ از CT سهبعدی تا بخشبندی تصاویر X-ray
نوآوری اصلی FleXray فقط در معماری شبکهی عصبی نیست؛ بخش مهمی از پژوهش به طراحی یک فرایند تولید دادهی آموزشی اختصاص دارد که بتواند تنوع آناتومیکی، هندسهی تصویربرداری و ظاهر تصاویر بالینی را پوشش دهد.
۳.۱. تولید تصاویر X-ray مصنوعی از CT سهبعدی
پژوهشگران از مجموعهدادههای CT سهبعدی دارای برچسبهای آناتومیکی استفاده میکنند. این برچسبها مشخص میکنند هر ساختار، مانند استخوان، مهره یا اندام داخلی، در حجم سهبعدی کجا قرار دارد.
سپس با استفاده از روش Digitally Reconstructed Radiograph (DRR)، عبور پرتوها از حجم CT شبیهسازی میشود و یک تصویر رادیوگرافی مصنوعی به دست میآید. با تغییر زاویهی دید، موقعیت منبع پرتو، فاصلهی منبع تا آشکارساز و هندسهی تصویربرداری، میتوان از یک حجم CT چندین نمای متفاوت تولید کرد.
نکتهی مهم این است که برچسبهای آناتومیکی نیز با هندسهی همان تصویر به فضای دوبعدی منتقل میشوند. در نتیجه، هر تصویر مصنوعی با اطلاعات مرجع موردنیاز برای آموزش مدل همراه است.
بااینحال، تصویر X-ray یک تصویر ساده از سطح اندامها نیست؛ هر پیکسل حاصل ترکیب اطلاعات در امتداد مسیر پرتو است. به همین دلیل، پژوهشگران برای تولید برچسبها از هندسهی پروجکشن استفاده میکنند و هر ساختاری را که پرتو از آن عبور کرده است، در ماسک متناظر در نظر میگیرند. این موضوع در بخشبندی چند ساختار همپوشان اهمیت دارد.
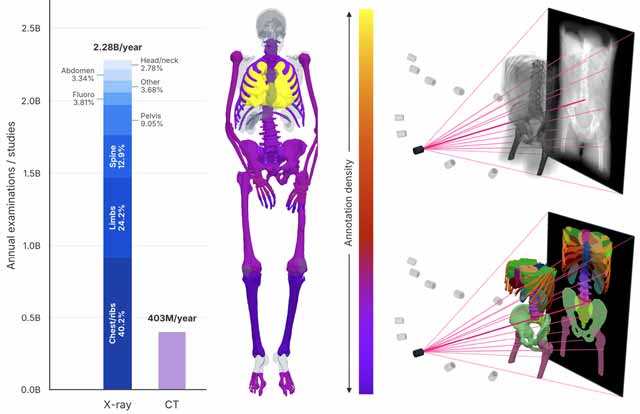

برای مشاهدهی روند تولید تصاویر مصنوعی و نمونههای برچسبگذاریشده، به شکل ۱ مقاله مراجعه کنید
این شکل نشان میدهد چگونه یک CT سهبعدی میتواند به چندین تصویر رادیوگرافی با برچسبهای متناظر تبدیل شود.
۳.۲. چرا DRR بهتنهایی کافی نیست؟
تصاویر DRR از نظر هندسهی تصویربرداری مفید هستند، اما از نظر ظاهری الزاماً با تصاویر واقعی رادیولوژی مطابقت ندارند. برای مثال، تفاوتهای مربوط به نویز، شدت روشنایی، کنتراست و ویژگیهای آشکارساز میتوانند باعث شوند مدلی که فقط روی DRR آموزش دیده است، در تصاویر واقعی عملکرد ضعیفتری داشته باشد.
برای کاهش این فاصله، FleXray از دو راهبرد مکمل استفاده میکند:
- تنوعبخشی به ظاهر تصاویر (Appearance Randomization): تغییر کنترلشدهی ویژگیهای ظاهری تصاویر آموزشی برای کاهش وابستگی مدل به یک ظاهر مشخص.
- تقویت مولد تصاویر (Generative Enhancement): استفاده از مدل ویرایش تصویر2 برای تبدیل برخی DRRها به تصاویری با ظاهر نزدیکتر به رادیوگرافی واقعی، درحالیکه برچسبهای پروجکتشده حفظ میشوند.
پژوهشگران این تصاویر تقویتشده را بهصورت آفلاین تولید میکنند تا فرایند تولید تصویر در هر مرحلهی آموزش به یک گلوگاه محاسباتی تبدیل نشود.
نکتهی علمی مهم این است که واقعگرایی ظاهری بهتنهایی تضمینکنندهی تعمیمپذیری نیست. نتایج تحلیلهای حذف مؤلفهها در مقاله نشان میدهند که پوشش مناسب تنوع آناتومیکی، هندسهی تصویربرداری و ظاهر دادهها اهمیت اساسی دارد. در برخی شرایط، تصادفیسازی ظاهر سهم بیشتری از بهبود را ایجاد میکند و تقویت مولد نیز برای شرایطی که شبیهسازی تحلیلی با تصاویر واقعی فاصلهی بیشتری دارد، مفید است.
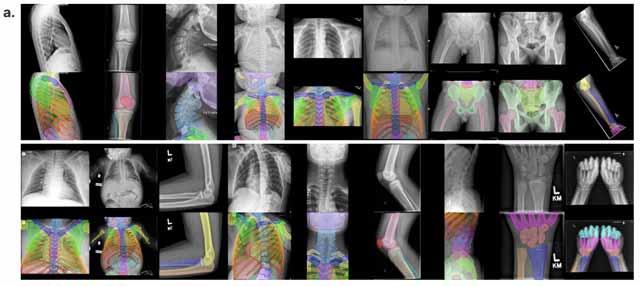
برای مشاهدهی تصاویر با کیفیت و بهویژه بخشهای مربوط به تأثیر تنوع هندسهی تصویربرداری، تقویت مولد و تغییرات چگالی تصویر ، به شکل 4 مقاله مراجعه کنید.
۳.۳. ترکیب دادههای مصنوعی و واقعی
FleXray تنها با DRR آموزش داده نمیشود. پژوهشگران سه منبع اصلی داده را ترکیب میکنند:
- DRRهایی که بهصورت آنلاین از CT تولید میشوند.
- DRRهای تولیدشده از پیش که با مدل مولد تقویت شدهاند.
- تصاویر واقعی X-ray دارای برچسب.
دادههای مشتقشده از مجموعهدادهی MOOSE، بخش اصلی فرایند آموزش را تشکیل میدهند. در هر عضو از مدل نهایی، دادههای مشتقشده از MOOSE برابر با ۷۵ درصد بودجهی نمونهگیری را تشکیل میدهند و ۲۵ درصد باقیمانده از منابع تکمیلی CT و X-ray تأمین میشود.
پژوهشگران همچنین سهم DRRهای آنلاین و تصاویر تقویتشدهی آفلاین را میان مدلهای مختلف تغییر میدهند. این طراحی اجازه میدهد اثر ترکیب دو راهبرد تولید داده بررسی شود، نه اینکه از ابتدا فرض کنیم یکی از آنها بهتنهایی بهترین است.

۳.۴. معماری و آموزش مدل
مدل بخشبندی FleXray بر پایهی یک معماری دوبعدی از خانوادهی U-Net طراحی شده است. این مدل برای پیشبینی همزمان ۶۰ ساختار آناتومیکی، خروجیهای مستقل مربوط به هر ساختار را تولید میکند.
ازآنجاکه در تصویر رادیوگرافی چند ساختار میتوانند روی یک پیکسل قرار بگیرند، مسئله الزاماً یک طبقهبندی تکبرچسبی برای تمام پیکسلها نیست. در این روش، هر ساختار یک نقشهی احتمال مستقل دارد و میتواند با ساختارهای دیگر همپوشانی داشته باشد.
سیستم منتشرشدهی FleXray از پنج شبکهی مستقل تشکیل شده است که در معرض نسبتهای متفاوتی از دادههای تقویتشدهی مولد قرار گرفتهاند. پیشبینیهای این شبکهها با هم ترکیب میشوند. علاوه بر این، از Test-Time Augmentation (TTA) با ۱۶ نمونه استفاده میشود تا پیشبینی مدل از چند نسخهی تبدیلشدهی تصویر ترکیب شود.
هدف از این دو راهبرد، افزایش پایداری در برابر تنوع تصاویر واقعی است؛ هرچند هزینهی محاسباتی بیشتری دارند. برای آزمایشهای حذف مؤلفهها و Fine-tuning، پژوهشگران از نسخهی تکمدلی FleXray استفاده میکنند تا اثر مؤلفههای مختلف را مستقلتر بررسی کنند.
۴. نتایج و ارزیابی FleXray
پژوهشگران مدل را فقط روی تصاویر مصنوعی ارزیابی نمیکنند؛ هدف اصلی، بررسی عملکرد آن روی تصاویر واقعی است که در آموزش مدل استفاده نشدهاند. این ارزیابی شامل هشت مجموعهدادهی مستقل از نواحی مختلف بدن، از جمله اندامها، لگن، ستون فقرات و قفسهی سینه است.
مشخصات این مجموعهدادهها، تعداد تصاویر و برچسبهای مورد ارزیابی در جدول ۴ مقاله آمده است.
۴.۱. عملکرد بخشبندی روی هشت مجموعهدادهی مستقل
معیار اصلی گزارششده، ضریب Dice است که میزان همپوشانی ماسک پیشبینیشده و ماسک مرجع را اندازهگیری میکند. مقدار Dice بالاتر نشاندهندهی همپوشانی بیشتر است، اما بهتنهایی تمام جنبههای کیفیت بالینی یک ماسک را نشان نمیدهد.
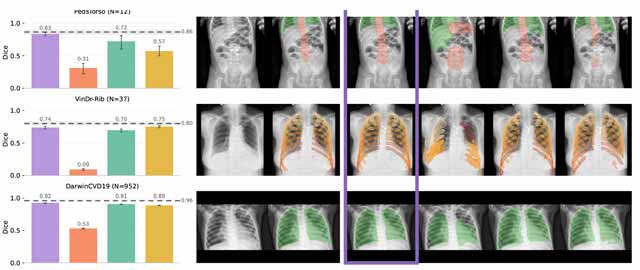
FleXray در ارزیابی هشت مجموعهداده به میانگین Dice برابر با ۰٫۸۷۵ رسید؛ میانگینی که در آن هر مجموعهداده وزن یکسانی دارد. این مدل در هفت مجموعه از هشت مجموعه، از تمام روشهای عمومیِ قابلمقایسهی همان مجموعه عملکرد بهتری داشت. در مجموعهدادهی VinDr-Rib، تفاوت آن با PAXray از نظر آماری معنادار نبود.
برای مقایسهی دقیقتر، پژوهشگران مدلهای nnU-Net را نیز بهصورت جداگانه روی دادههای آموزشی هر مجموعهداده آموزش دادند. این مدلهای تخصصی به میانگین Dice برابر با ۰٫۹۱۴ رسیدند؛ بنابراین، عملکرد FleXray با وجود اینکه روی مجموعهدادههای ارزیابی آموزش ندیده بود، به مدلهای تخصصی نزدیک بود.
در مجموعهدادهی DeepFluoro، FleXray به Dice برابر با ۰٫۹۱۵ رسید، درحالیکه nnU-Net آموزشدیده روی همان مجموعهداده به ۰٫۸۶۶ رسید. یکی از توضیحهای مطرحشده در مقاله این است که DeepFluoro دادهی آموزشی محدودی دارد و زاویههای تصویربرداری متنوعی را پوشش میدهد؛ شرایطی که میتواند به نفع مدلی باشد که روی هندسههای متنوعتری آموزش دیده است.

برای دیدن خروجیهای کیفی و مقایسهی عملکرد، به شکل ۳ و جدول 6 مقاله مراجعه کنید.
۴.۲. تعمیمپذیری به شرایط تصویربرداری متفاوت
یکی از مشکلات رایج در بخشبندی تصاویر پزشکی این است که تغییر زاویهی تصویربرداری یا ظاهر تصویر میتواند عملکرد مدل را کاهش دهد. برای بررسی این موضوع، پژوهشگران عملکرد FleXray را در تصاویر دارای زاویههای مختلف و همچنین تصاویر خارج از مجموعهدادههای استاندارد بررسی کردهاند.
در آزمایش DeepFluoro، میانگین Dice مدل برابر با ۰٫۹۱۵ بود. با افزایش فاصلهی زاویهی تصویربرداری از نمای روبهرو، عملکرد بهطور کلی کاهش یافت؛ اما برای برخی ساختارها مانند استخوان ران، مفصل ران و استخوان خاجی، تغییر عملکرد در محدودهی بررسیشده نسبتاً محدود باقی ماند.
پژوهشگران همچنین مدل را روی تصاویر متنوعی از Radiopaedia بررسی کردند؛ تصاویری با نماهای روبهرو، جانبی و مایل، میدان دیدهای متفاوت و جمعیتهای بزرگسال و کودک. خروجیهای کیفی نشان دادند که مدل در بسیاری از این شرایط نیز ماسکهای آناتومیکی منسجمی تولید میکند.
برای دیدن تصاویر کامل و با کیفیت شکل 4 مقاله را بررسی کنید.
این نتایج امیدوارکنندهاند، اما باید توجه داشت که ارزیابی کیفی روی تصاویر خارج از مجموعهدادهها بهتنهایی جایگزین اعتبارسنجی کمی گسترده در محیطهای بالینی واقعی نیست.
۴.۳. کاربرد اول: اندازهگیری خودکار زاویهی Cobb
یکی از کاربردهای پاییندستی FleXray، اندازهگیری زاویهی Cobb برای ارزیابی شدت انحنای ستون فقرات است. این زاویه یکی از معیارهای رایج در بررسی اسکولیوز به شمار میرود.
در این روش، مدل ابتدا مهرهها را در تصویر X-ray بخشبندی میکند. سپس از ماسکهای پیشبینیشده برای تخمین جهت صفحات انتهایی مهرهها و محاسبهی زاویهی Cobb استفاده میشود.
در مجموعهدادهی AASCE، شامل ۲۱۸ تصویر، FleXray برای تمام تصاویر یک اندازهگیری قابلمحاسبه تولید کرد و به میانگین خطای مطلق ۵٫۱۳ درجه رسید. این خطا در محدودهای قرار دارد که باید در کنار تغییرپذیری اندازهگیریهای انسانی تفسیر شود.
برای مقایسه، TotalSegmentator2D به خطای مطلق میانگین ۶٫۳۸ درجه رسید؛ درحالیکه خطای PAXray و FluoroSAM بیشتر بود و این روشها در تعدادی از تصاویر نتوانستند اندازهگیری قابلمحاسبه تولید کنند.

شکل ۵، بخشهای a و b، فرایند تبدیل ماسک مهرهها به زاویهی Cobb و مقایسهی خطای اندازهگیری را نشان میدهد.
البته این نتیجه به معنای جایگزینی اندازهگیری تخصصی یا تأیید کاربرد مستقل بالینی مدل نیست؛ بلکه نشان میدهد بخشبندی خودکار میتواند بخشی از زنجیرهی تحلیل کمی تصاویر پزشکی را خودکار کند.
۴.۴. کاربرد دوم: کمک به ثبت تصاویر دوبعدی و سهبعدی
در مداخلات هدایتشده با X-ray، گاهی لازم است تصویر دوبعدی فلوروسکوپی با حجم CT سهبعدی هماهنگ شود. این مسئله با عنوان 2D/3D Registration شناخته میشود و میتواند برای تخمین موقعیت دستگاه تصویربرداری یا هدایت ابزارهای پزشکی اهمیت داشته باشد.
یکی از چالشهای ثبت تصویر، گیر افتادن الگوریتم بهینهسازی در جوابهای نامناسب است؛ بهخصوص زمانی که زاویهی اولیهی تصویربرداری با وضعیت واقعی فاصلهی زیادی داشته باشد.
پژوهشگران از ماسکهای آناتومیکی FleXray برای ساخت یک جملهی هزینهی مبتنی بر فاصلهی Chamfer استفاده کردند. این جملهی هزینه اطلاعات معنایی مربوط به ساختارهای آناتومیکی را به فرایند ثبت تصویر اضافه میکند.
در آزمایش DeepFluoro، هنگام شروع از یک وضعیت روبهروی دستی، میانهی خطای ثبت با روش تصویری پایه به حدود ۳۳۵٫۳ میلیمتر رسید و نرخ شکست کلی ۸۶٫۴ درصد بود. با افزودن جملهی هزینهی مبتنی بر بخشبندی FleXray، میانهی خطا به حدود ۱٫۲ میلیمتر کاهش یافت و نرخ شکست کلی به ۱۲٫۷ درصد رسید.
در آزمایش دیگری که از مقداردهی اولیهی یک مدل پیشبینیکنندهی وضعیت دستگاه استفاده میکرد، افزودن اطلاعات آناتومیکی توانست هشت مورد شکست شدید با خطای بیش از ۵۰ میلیمتر را اصلاح کند.
این نتایج نشان میدهند که اطلاعات بخشبندی میتواند بهعنوان یک قید معنایی، الگوریتمهای ثبت تصویر را در شرایط دشوار پایدارتر کند.
۴.۵. کاربرد سوم: یادگیری انتقالی با دادهی برچسبخوردهی کمتر
یکی از پرسشهای مهم در هوش مصنوعی پزشکی این است که آیا مدلی که آناتومی عمومی را آموخته، میتواند در یک وظیفهی جدید با تعداد محدودی نمونهی برچسبخورده به عملکرد مناسبی برسد؟
برای بررسی این موضوع، پژوهشگران FleXray را برای دو وظیفهی جدید Fine-tune کردند:
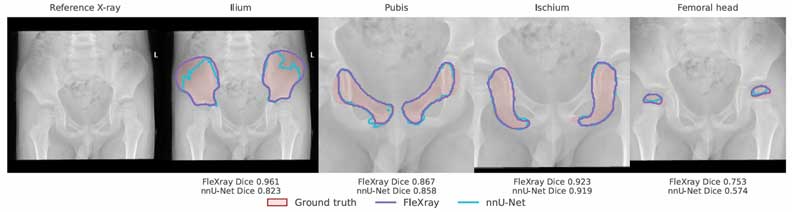
- بخشبندی آناتومی ظریف لگن در کودکان مبتلا به دیسپلازی هیپ، با مجموعهدادهی MTDDH؛
- تشخیص تومور استخوانی در تصاویر X-ray، با مجموعهدادهی
در این آزمایشها، سر خروجی مدل برای وظیفهی جدید جایگزین شد و شبکه با درصدهای متفاوتی از دادههای آموزشی تنظیم شد. عملکرد آن با nnU-Net مقایسه شد که از مقداردهی اولیهی تصادفی آموزش میدید.
در وظیفهی بخشبندی لگن کودکان، استفاده از تنها ۱ درصد دادهی آموزشی، معادل شش بیمار، باعث شد FleXray به میانگین Dice برابر با ۰٫۸۹۶ برسد؛ درحالیکه nnU-Net از مقداردهی اولیهی تصادفی به ۰٫۸۶۷ رسید.
در وظیفهی تشخیص تومور استخوانی، با استفاده از ۱۰ درصد دادهی آموزشی، FleXray به AP50 برابر با حدود ۲۳ درصد رسید؛ درحالیکه مقدار متناظر برای nnU-Net حدود ۷ درصد بود. حتی با استفاده از یک درصد دادهی آموزشی، عملکرد FleXray حدود ۵ درصد بود، درحالیکه مقدار nnU-Net حدود ۰٫۴ درصد گزارش شد.
این نتایج نشان میدهند که مقداردهی اولیه از یک مدل عمومی آناتومیکی میتواند در شرایط کمبود برچسب سودمند باشد؛ بهخصوص زمانی که وظیفهی جدید به ویژگیهای آناتومیکی آموختهشده وابسته است.
۵. چگونه FleXray را اجرا کنیم؟
یکی از مزیتهای این پروژه، انتشار کد، مدلهای آموزشدیده و ابزارهای لازم برای استفادهی پژوهشی است. برای شروع، دو مسیر اصلی وجود دارد: استفاده از دموی آنلاین یا اجرای مدل با پایتون.
روش اول: استفاده از دموی آنلاین
برای آزمایش سریع مدل میتوانید به صفحهی رسمی پروژه مراجعه کنید:
https://flexray.csail.mit.edu/
تصویر X-ray را بارگذاری کنید و خروجی بخشبندی ساختارهای آناتومیکی را مشاهده کنید. طبق توضیحات پروژه، پردازش تصویر در مرورگر و روی دستگاه کاربر انجام میشود و تصویر بارگذاریشده برای این فرایند به سرور ارسال نمیشود.
این دمو برای آشنایی با قابلیتهای مدل و بررسی نمونههای پژوهشی مناسب است؛ اما خروجی آن نباید مبنای تشخیص یا تصمیمگیری درمانی قرار گیرد.
روش دوم: نصب و اجرای FleXray با پایتون
برای اجرای مدل روی سیستم خود، به Python 3.10 یا نسخهی جدیدتر نیاز دارید. سادهترین راه نصب بستهی پروژه از طریق pip است:
Python
python -m pip install flexray
سپس میتوانید یک تصویر را با دستور flexify پردازش کنید:
Python
flexify --input ./image.png --output-dir ./predictions
این دستور خروجیهای مربوط به ماسکهای بخشبندی، احتمالهای پیشبینی و امتیازهای خام مدل را در مسیر تعیینشده ذخیره میکند.
استفاده از FleXray در کد پایتون
اگر میخواهید خروجی مدل را مستقیماً در یک برنامهی پژوهشی یا خط پردازش تصاویر پزشکی استفاده کنید، میتوانید از API پایتون پروژه کمک بگیرید:
Python
from fxr.inference import FleXraySegmenter
# بارگذاری مدل از پیش آموزشدیده
Python
segmenter = FleXraySegmenter.from_pretrained()
# پیشبینی روی تصویر X-ray
Python
prediction = segmenter.predict("./image.png")
# دسترسی به خروجیها
Python
masks = prediction.masks
probabilities = prediction.probabilities
logits = prediction.logits
در این مثال:
- masks شامل ماسکهای بخشبندیشده است.
- probabilities احتمالهای پیشبینی برای کانالهای خروجی را نگه میدارد.
- logits امتیازهای خام مدل پیش از تبدیل به احتمال را ارائه میکند.
برای استفاده از مدل پنجعضوی، میتوانید آن را به شکل زیر بارگذاری کنید:
segmenter = FleXraySegmenter.from_pretrained(ensemble=True)
prediction = segmenter.predict(“./image.png”, tta_samples=16)
در این حالت، مدل از یک مجموعهی پنجتایی استفاده میکند و با افزایش تعداد نمونههای Test-Time Augmentation، چندین پیشبینی را ترکیب میکند. این کار محاسبات بیشتری نیاز دارد و لزوماً برای تمام تصاویر یا کاربردها بهترین انتخاب نیست.
نکتهی مهم: خروجیهای کتابخانه در وضوح پردازششدهی مدل ارائه میشوند و لزوماً به ابعاد اصلی تصویر بازگردانده نمیشوند. همچنین، خروجیهای پیشبینی باید پیش از استفاده در تحلیلهای بعدی با دقت تفسیر شوند.
مستندات کامل نصب و اجرا:
https://github.com/VictorButoi/FleXray
۶. محدودیتها و نکات مهم
با وجود نتایج امیدوارکننده، FleXray هنوز یک ابزار پژوهشی است و نباید آن را سامانهی تأییدشده برای تشخیص پزشکی یا تصمیمگیری درمانی در نظر گرفت.
چند نکته در استفاده از آن اهمیت دارد:
- پوشش ساختارها محدود به پروتکل مدل است: مدل ۶۰ ساختار تعریفشده را پیشبینی میکند و برای هر ساختار آناتومیکی قابلتصور طراحی نشده است.
- عملکرد به شرایط تصویربرداری وابسته است: تصاویر خارج از توزیع دادههای آموزشی، دستگاههای متفاوت، نماهای غیرمعمول یا جمعیتهای کمتر بررسیشده ممکن است عملکرد متفاوتی ایجاد کنند.
- پیشبینی آناتومی با تشخیص بیماری یکسان نیست: بخشبندی استخوان، ریه یا اندامهای دیگر بهتنهایی به معنی تشخیص بیماری نیست.
- کیفیت ماسکها باید بررسی شود: در کاربردهای حساس، بهویژه اندازهگیریهای بالینی یا هدایت مداخلات، خطاهای بخشبندی میتوانند روی نتایج بعدی اثر بگذارند.
- محدودیتهای خروجی فنی را در نظر بگیرید: مدل در وضوح مشخصی پیشبینی میکند، سمت چپ و راست ساختارهای جفتشده را جداگانه گزارش نمیکند و خروجی آن نباید بدون کنترل کیفیت وارد یک فرایند بالینی شود.
بنابراین، پیش از استفاده در یک پژوهش جدید، لازم است مدل روی دادههای مرتبط با همان کاربرد ارزیابی شود و عملکرد آن با معیارهای مناسب و در صورت لزوم با ارزیابی متخصصان مقایسه شود.
جمعبندی
FleXray نمونهای از ترکیب هوشمندانهی بین تصویربرداری پزشکی، یادگیری عمیق و تولید دادهی مصنوعی است. ایدهی اصلی این پژوهش، استفاده از اطلاعات آناتومیکی موجود در CT سهبعدی برای ساخت دادههای آموزشی متنوع و آموزش یک مدل عمومی برای بخشبندی تصاویر X-ray است.
نتایج مقاله نشان میدهند که چنین مدلی میتواند در چندین ناحیهی بدن عملکرد رقابتی داشته باشد و مبنایی برای اندازهگیری خودکار، ثبت تصاویر دوبعدی و سهبعدی و آموزش مدلهای تخصصی با دادهی کمتر فراهم کند.
برای دانشجویان و پژوهشگران مهندسی پزشکی، بینایی ماشین و یادگیری عمیق، FleXray نمونهی ارزشمندی از این نکته است که پیشرفت در هوش مصنوعی پزشکی همیشه به طراحی یک معماری جدید محدود نمیشود؛ گاهی نوآوری اصلی در نحوهی تولید داده، ترکیب منابع مختلف و طراحی یک مسیر یادگیری قابلتعمیم قرار دارد.
منابع و لینکهای بیشتر
- مقالهی اصلی: https://arxiv.org/abs/2609.26756
- مخزن کد GitHub: https://github.com/VictorButoi/FleXray
- دموی آنلاین: https://flexray.csail.mit.edu/
- مدلهای آموزشدیده: https://huggingface.co/VictorButoi/flexray
- مجموعهداده: https://huggingface.co/datasets/VictorButoi/flexray-data
FleXray برای استفادهی پژوهشی منتشر شده است و جایگزین ارزیابی رادیولوژیست یا ابزار تأییدشدهی تصمیمگیری بالینی نیست.
دوره های مرتبط
پیادهسازی شبکه های عصبی با پایتورچ PyTorch
 محمد نوری زاده چرلو
دوره جامع و پروژه محور کاربرد شبکه های عمیق در بینایی ماشین
 هما کاشفی
دوره جامع و پروژه محور شبکه عصبی بازگشتی RNN

عملیات مورفورلوژی در پردازش تصویر (فصل چهارم)
 محمد نوری زاده چرلو
فیلترهای مکانی در پردازش تصویر(فصل 3)
پردازش تصویر(فصل دوم): پردازش هیستوگرام تصویر
دیدگاه ها